
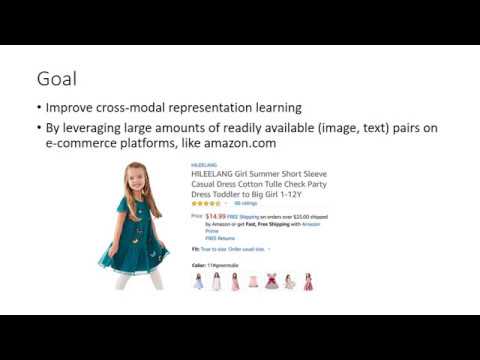
Video unavailable
This video can't be played right now.
T-VSE: Transformer-Based Visual Semantic Embedding
CVPR 2020 Workshop on Computer Vision for Fashion, Art, and Design Paper: https://arxiv.org/abs/2005.08399 Authors: Muhammet Bastan (Amazon), Arnau Ramisa (Amazon), Mehmet Tek (Google)
Suggested videos
Learning the Best Pooling Strategy for Visual Semantic Embedding (CVPR 2021)
Jiacheng Chen · 5:01

3.000 TL’ye Akvaryum Kurulur mu? Baştan Sona Kurulum! (üretim odaklı fish tank)
CikletZone Akvaryum · 4:53

Multilabel Deep Visual Semantic Embedding
IFoxProjects · 1:33

Vatan Marşı
Türk Silahlı Kuvvetleri · 3:06
Weakly Supervised Visual Semantic Parsing
ComputerVisionFoundation Videos · 5:00
Domestic Fury 3 - Episode 446 (Güldür Güldür Show)
Güldür Güldür · 19:52

Visual-Semantic Alignments (Q&A) | Lecture 59 (Part 3) | Applied Deep Learning (Supplementary)
Maziar Raissi · 13:05
Evli bir CEO’yu baştan çıkarmak için her yolu deneyen hizmetçi, aslında gizlice intikam almaktadır
Kalp Atışı Sinema · 2:00:38
Group Discussion of Learning the Best Pooling Strategy for Visual Semantic Embedding
AI Journal Club · 51:55
Hakan Fidan mı İmamoğlu mu? Baştan Sona Kesintisiz Şok Sonuçlu Anket!
Ortaya Karışık · 12:14
Semantic Labels-Aware Transformer Model for Searching Over a Large Collection of Lecture-Slides
ComputerVisionFoundation Videos · 9:08

HAYIR İŞİ OLDU MU BAŞTAN SAVMA YAPIYOR
Kemal Savaş · 8:55